caso de estudio
case study
AlzoLab
Laboratorio de lingüística de corpus en el navegador, sin escribir código. Flujo completo: importación multifuente → limpieza y normalización → análisis morfosintáctico con spaCy → extracción terminológica (C-value) → concordancias KWIC → exportación.
Browser-based corpus-linguistics lab, no coding required. End-to-end flow: multi-source import → cleaning and normalization → morphosyntactic analysis with spaCy → term extraction (C-value) → KWIC concordances → export.
Probar la demo en vivoTry the live demo
Qué hace
What it does
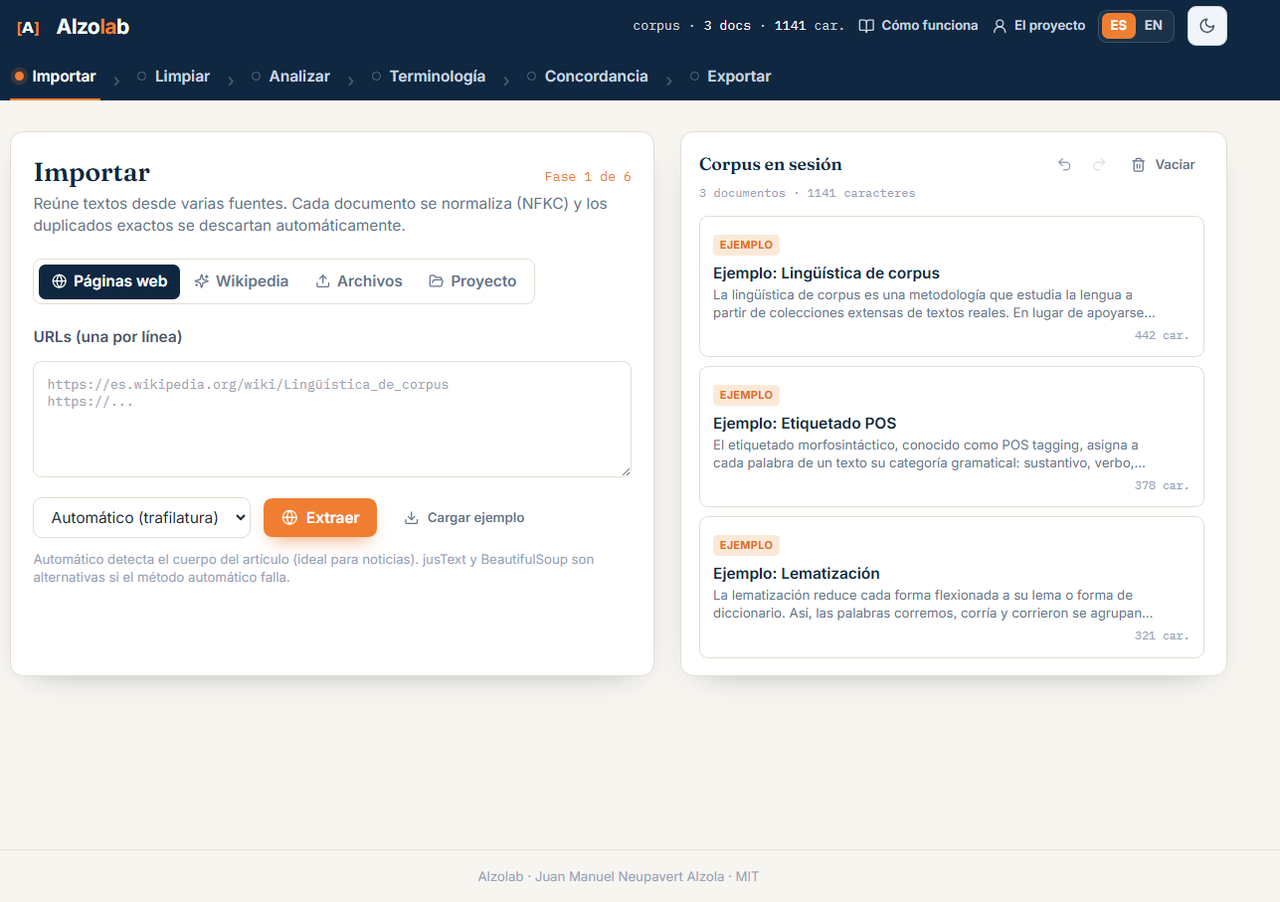
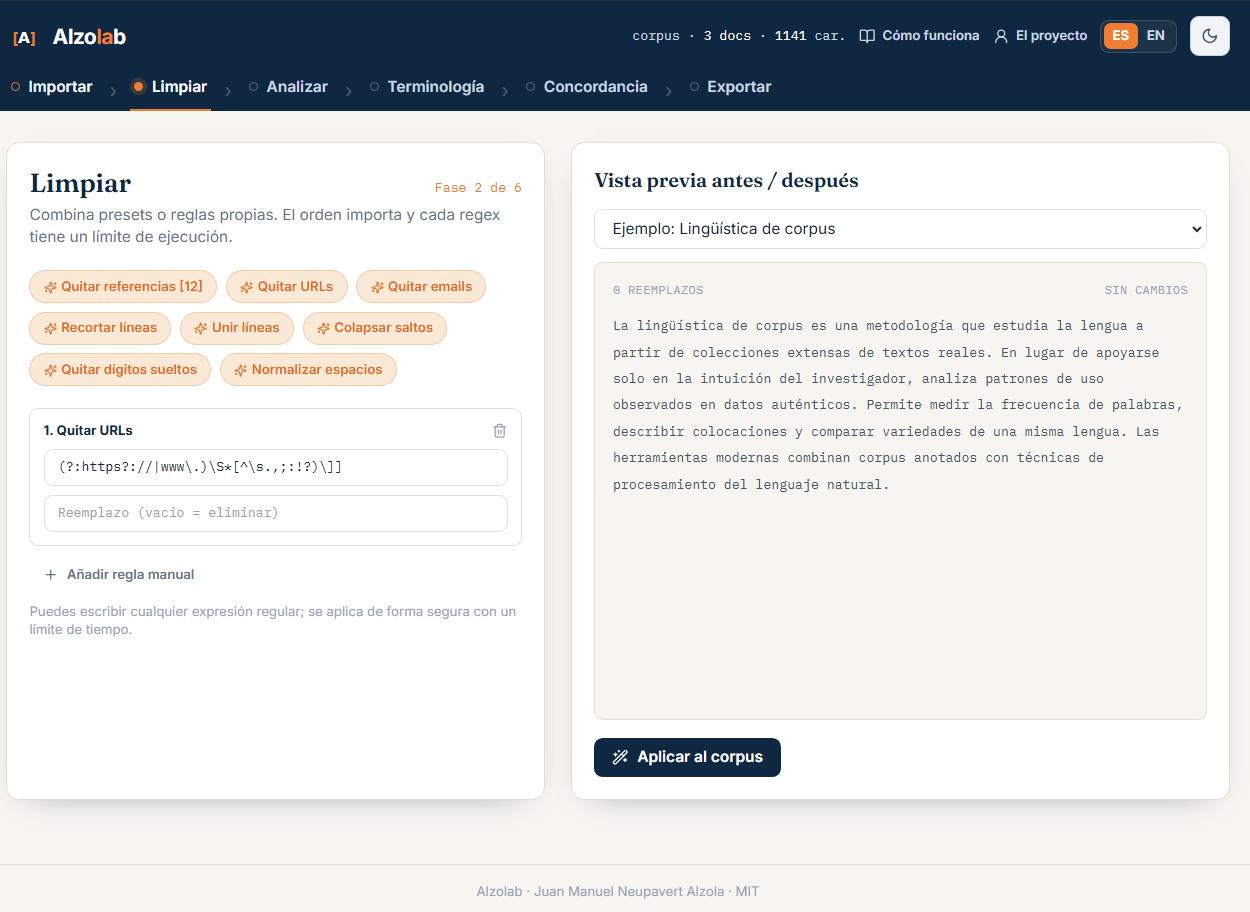
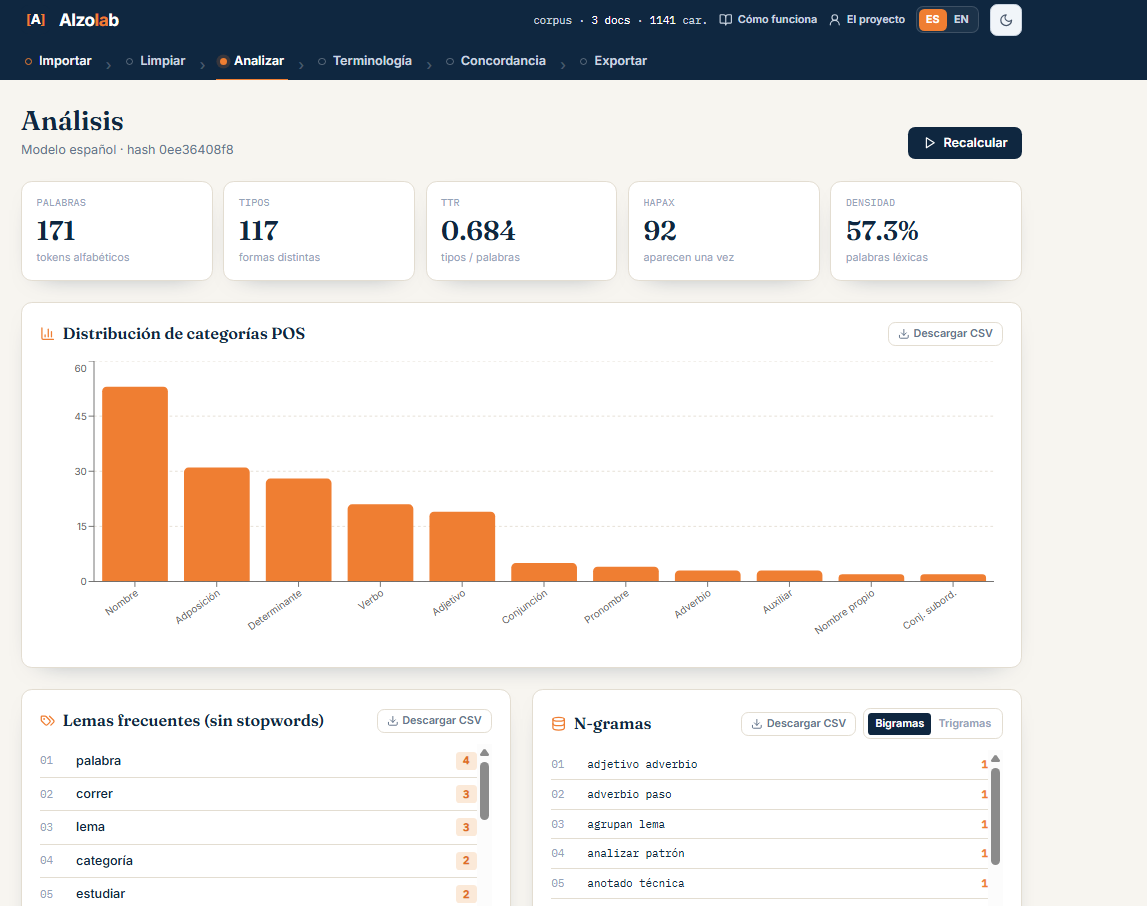
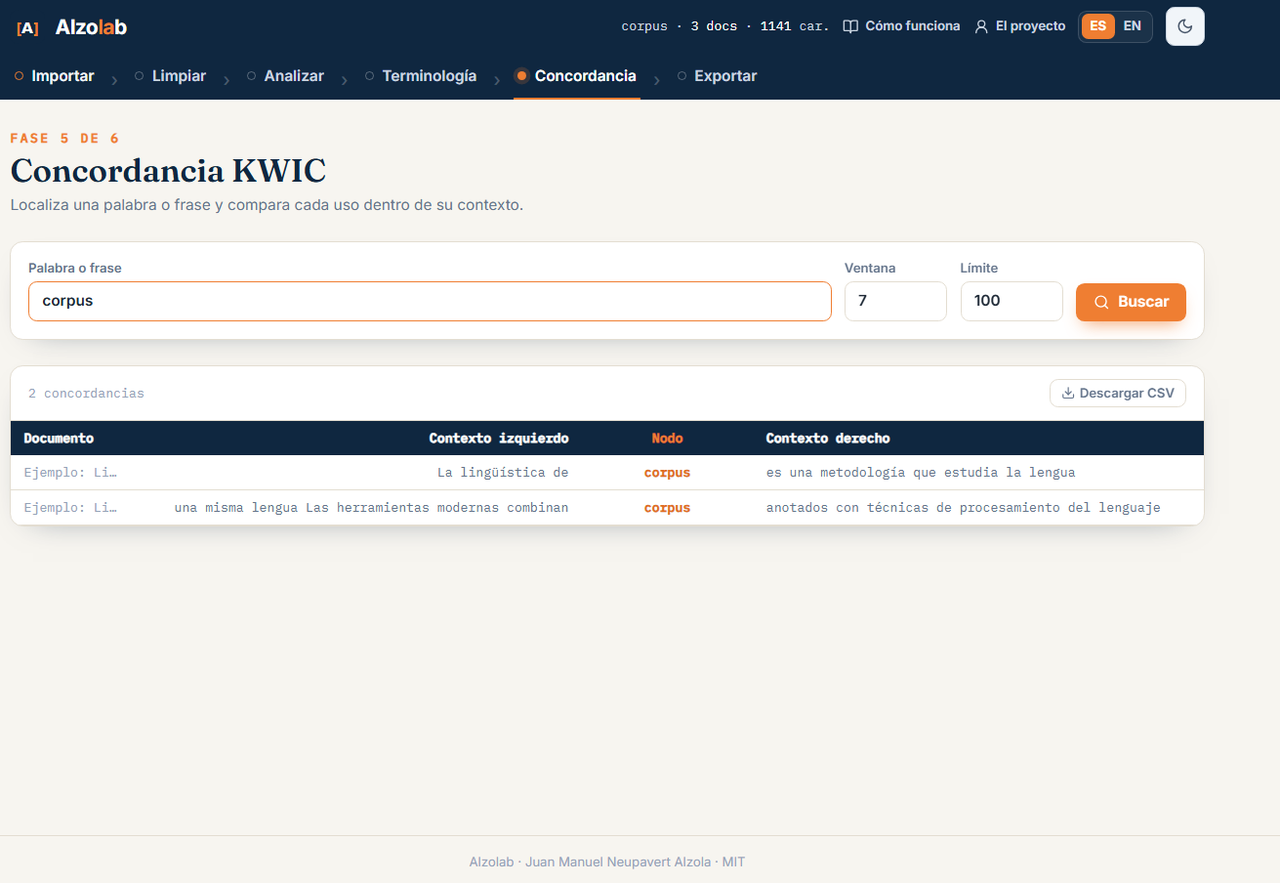
Convierte un conjunto de textos en un corpus analizable sin escribir una línea de código: importación desde varias fuentes (web, Wikipedia, archivos propios), limpieza y normalización, análisis morfosintáctico con spaCy, extracción automática de términos relevantes y concordancias KWIC para ver cada término en su contexto real de uso. Funciona en español e inglés — un único selector cambia tanto el idioma de la interfaz como el modelo de spaCy usado en el análisis.
La extracción terminológica usa el algoritmo C-value (Frantzi, Ananiadou y Mima, 2000), un método estadístico-lingüístico estándar en la literatura de extracción terminológica, no una heurística improvisada.
Todo el flujo — desde subir los textos hasta exportar los resultados — ocurre dentro de la misma interfaz, pensado para alguien sin experiencia de programación. El código es abierto (MIT) y está en GitHub, con tests automáticos en cada cambio.
It turns a set of texts into an analyzable corpus without writing a line of code: import from several sources (web, Wikipedia, own files), cleaning and normalization, morphosyntactic analysis with spaCy, automatic term extraction, and KWIC concordances to see each term in its real context of use. It works in Spanish and English — a single selector switches both the interface language and the spaCy model used in the analysis.
Term extraction uses the C-value algorithm (Frantzi, Ananiadou & Mima, 2000), a standard statistical-linguistic method in the term-extraction literature, not an improvised heuristic.
The whole flow — from uploading the texts to exporting the results — happens inside the same interface, built for someone with no programming experience. The code is open source (MIT) and on GitHub, with automated tests on every change.
Cómo se ve en uso
How it looks in use
Servicios relacionados
Related services
- Extracción de terminología especializada de un fondo documental (técnico, jurídico, médico) como base para un glosario o una memoria de traducción, en español o en inglés.
- Análisis de corpus a medida para traductores, editoriales o equipos de contenido que trabajan con grandes volúmenes de texto — importación desde web, Wikipedia o archivos propios incluida.
- Puesta en marcha de una instancia propia si necesitas mantener tu corpus separado del demostrador público.
- Extracting specialized terminology from a document collection (technical, legal, medical) as the basis for a glossary or translation memory, in Spanish or English.
- Custom corpus analysis for translators, publishers or content teams working with large volumes of text — import from the web, Wikipedia or your own files included.
- Setting up your own instance if you need to keep your corpus separate from the public demo.
Arquitectura detallada, dificultades y aprendizajes concretos: este caso de estudio se ampliará con esos apartados según avance el proyecto — de momento la descripción de arriba es todo lo documentado.
Detailed architecture, difficulties and concrete lessons learned: this case study will grow those sections as the project moves forward — for now, the description above is everything that's documented.
Ver el código en GitHubView the code on GitHub
¿Un problema parecido? A similar problem?
juanmanuel@neupavert.com
Aviso legalLegal notice ·
Política de privacidadPrivacy policy