…lingüista computacional que también programa → JUAN MANUEL NEUPAVERT ← especialista en automatización documental…
…computational linguist who also writes code → JUAN MANUEL NEUPAVERT ← document-automation specialist…
Juan Manuel Neupavert Alzola
Especialista en servicios tecnológicos y lingüísticos · Jerez de la Frontera
Technology & language specialist · Jerez de la Frontera
Automatizo procesos documentales para empresas: digitalización de archivo,
consulta inteligente de documentación y sistemas de gestión de conocimiento,
siempre con opción de funcionamiento local y privado. Mi formación en
lingüística computacional añade una capa extra cuando el proyecto trabaja
con terminología o lenguaje especializado.
I automate document processes for companies: archive digitization,
intelligent document search, and knowledge-management systems, always
with a local, private-by-design option. My background in computational
linguistics adds an extra layer when the project involves specialized
terminology or language.
¿Tienes un archivo documental, un proceso manual que automatizar o un problema terminológico? Hablemos
Have a document archive, a manual process to automate, or a terminology problem? Let's talk
Qué hago
What I do
Lo más habitual: tienes documentación en papel, o repartida en carpetas sin criterio, y encontrar algo cuesta. La digitalizo, la organizo y te la devuelvo en PDF buscable, clasificada y con control de calidad. A partir de ahí, si hay tareas que se repiten, las automatizamos.
The usual case: you have documents on paper, or scattered across folders with no system, and finding anything takes time. I digitize them, organize them and hand them back as searchable, classified PDFs with quality control. From there, if there are repetitive tasks, we automate them.
[ocr]Digitalización y OCRDigitization & OCRDocumentos escaneados a texto buscable y editable, sin depender de servicios en la nube.Scanned documents into searchable, editable text, with no dependency on cloud services.¿Por qué?Why?
Un archivo en papel o en PDF escaneado no se puede buscar ni indexar: hacerlo en local, además, evita subir documentos sensibles a un servicio externo solo para convertirlos.
A paper archive or a scanned PDF can't be searched or indexed — doing it locally also avoids uploading sensitive documents to an outside service just to convert them.
[rag]Consulta documental privadaPrivate document Q&APreguntas en lenguaje natural sobre una colección de documentos, con cita a la página de origen.Natural-language questions over a document collection, with citations back to the source page.¿Por qué?Why?
Buscar por palabra clave en cientos de páginas falla en cuanto la respuesta está formulada de otra forma; preguntar en lenguaje natural y ver la página exacta evita tener que fiarse a ciegas de la respuesta.
Keyword search across hundreds of pages misses answers phrased differently; asking in natural language and seeing the exact source page means never having to take the answer on faith.
[chat]Asistente conversacional para tu webAI assistant for your websiteChatbot alojado en la nube con acceso privado por enlace — sin tocar el código de tu web — para que tus usuarios o estudiantes pregunten sobre tus propios documentos a cualquier hora.Cloud-hosted chatbot with private link access — no changes to your website's code — so your users or students can ask about your own documents any time.¿Por qué?Why?
Una duda fuera de horario no siempre puede esperar a que alguien responda. Un asistente disponible a cualquier hora, que solo contesta con lo que hay en tus propios documentos —nunca con conocimiento genérico inventado, a diferencia de ChatGPT o Claude—, cubre ese hueco.
A question outside office hours can't always wait for someone to answer. An assistant available any time, answering only from your own documents — never inventing from generic knowledge like ChatGPT or Claude would — fills that gap.
[kb]Gestión de conocimiento documentalKnowledge managementFragmentos clave de tus documentos organizados, buscables y siempre vinculados al original.Key fragments from your documents, organized, searchable, and always linked back to the original.¿Por qué?Why?
La información repartida en decenas de documentos es difícil de mantener y de encontrar cuando hace falta; tenerla organizada y vinculada al original evita releer documentos enteros cada vez.
Information scattered across dozens of documents is hard to maintain and hard to find when you need it; keeping it organized and linked to the source avoids re-reading whole documents every time.
[datos]Extracción estructurada de documentosStructured document extractionConvierte cientos de documentos — contratos, artículos, informes — en una base de datos estructurada con los campos que necesites, no en un buscador.Turns hundreds of documents — contracts, articles, reports — into a structured database with the fields you need, not a search tool.¿Por qué?Why?
A veces no hace falta preguntar a los documentos, sino sacarles los datos de una vez: cliente, fecha, importe, autor, DOI... y volcarlos en una tabla que ya se pueda analizar, filtrar o cruzar con otros datos.
Sometimes the point isn't asking questions of the documents, but pulling the data out once and for all: client, date, amount, author, DOI... into a table that can already be analyzed, filtered, or cross-referenced with other data.
[limpieza]Limpieza y normalización de datosData cleaning & normalizationDetecta y unifica duplicados y variantes de un mismo dato — nombres, empresas, direcciones, productos — en hojas de cálculo y bases de datos.Detects and merges duplicates and variants of the same data — names, companies, addresses, products — across spreadsheets and databases.¿Por qué?Why?
Un mismo cliente escrito de cinco formas distintas en un Excel hace que ningún filtro, tabla dinámica o análisis posterior cuadre; unificarlo una vez evita arrastrar el error a cada informe futuro.
The same client written five different ways in a spreadsheet breaks every filter, pivot table and downstream analysis; fixing it once stops the error from carrying into every future report.
Terminología y lingüística
Terminology & linguistics
[termbase]Gestión terminológicaTerminology managementBases multilingües, migración entre formatos (TBX, XLIFF, TMX).Multilingual termbases; migration across formats (TBX, XLIFF, TMX).¿Por qué?Why?
Sin una base terminológica centralizada, cada traductor o redactor puede usar un término distinto para el mismo concepto — incoherencias que luego cuestan tiempo (y credibilidad) corregir.
Without a centralized termbase, different translators or writers end up using different terms for the same concept — inconsistencies that cost time (and credibility) to fix later.
[extract]Extracción de terminologíaTerm extractionCandidatos terminológicos a partir de corpus, criterios lingüísticos y estadísticos.Term candidates from corpora, using linguistic and statistical criteria.¿Por qué?Why?
Identificar a mano los términos clave de un corpus grande es lento; un proceso semi-automático acelera la fase inicial de cualquier proyecto terminológico.
Manually spotting the key terms in a large corpus is slow; a semi-automated process speeds up the first phase of any terminology project.
[qa]Control de calidad terminológicaTerminology QARevisión de coherencia en proyectos de traducción y localización.Consistency checks across translation and localization projects.¿Por qué?Why?
Un mismo término traducido de formas distintas dentro del mismo proyecto es uno de los errores de calidad más comunes en traducción y localización; revisarlo sistemáticamente evita que llegue al usuario final.
The same term translated inconsistently within one project is one of the most common quality issues in translation and localization; a systematic check catches it before it reaches the end user.
[corpus]Preparación de corpusCorpus buildingRecopilación, limpieza, normalización y análisis de textos especializados.Collection, cleaning, normalization, and analysis of specialized texts.¿Por qué?Why?
Un corpus mal limpiado o sin normalizar distorsiona cualquier análisis posterior; dedicarle tiempo a esta fase evita conclusiones erróneas más adelante.
A poorly cleaned or unnormalized corpus distorts any analysis built on top of it; getting this stage right prevents wrong conclusions down the line.
[recursos]Recursos lingüísticosLanguage resourcesGlosarios, guías de estilo terminológicas, memorias de traducción.Glossaries, terminology style guides, translation memories.¿Por qué?Why?
Sin glosarios ni memorias de traducción compartidas, cada proyecto nuevo repite decisiones terminológicas ya tomadas antes, perdiendo tiempo y consistencia.
Without shared glossaries or translation memories, every new project re-decides terminology choices already made before, losing both time and consistency.
[consultoría]Consultoría lingüísticaLinguistic consultingAsesoramiento en terminografía, documentación de dominios, estrategia terminológica.Advice on terminography, domain documentation, and terminology strategy.¿Por qué?Why?
Antes de construir cualquier base terminológica o proceso conviene tener claro qué necesita realmente el dominio y el equipo — evita construir algo que nadie acabará usando.
Before building any termbase or process, it helps to be clear on what the domain and team actually need — it avoids building something no one ends up using.
Son ejemplos de lo que sé construir, no la lista completa de lo que ofrezco — cada uno tiene un manual en PDF con más detalle. Si tu necesidad es distinta, hablemos.
These are examples of what I can build, not the full list of what I offer — each one has a PDF manual with more detail. If your need is different, let's talk.
Digitalización documental (escáner + OCR local)(scanner + local OCR)
Servicio activoActive service
Digitalizo tu archivo con un escáner cenital CZUR y un programa propio de reconocimiento de texto que funciona en local. Antes de entregar: limpieza automática de artefactos, corrector con diccionario del dominio y revisión humana página a página, marcando lo ilegible en vez de inventarlo.
I digitize your archive with a CZUR overhead scanner and an in-house text-recognition program that runs locally. Before delivery: automatic artifact cleanup, a domain-dictionary spellcheck and page-by-page human review, flagging what's illegible instead of guessing it.
Escáner cenital CZUR · reconocimiento de texto 100% local · entrega en Markdown + PDF buscable
CZUR overhead scanner · fully local text recognition · delivered as Markdown + searchable PDF
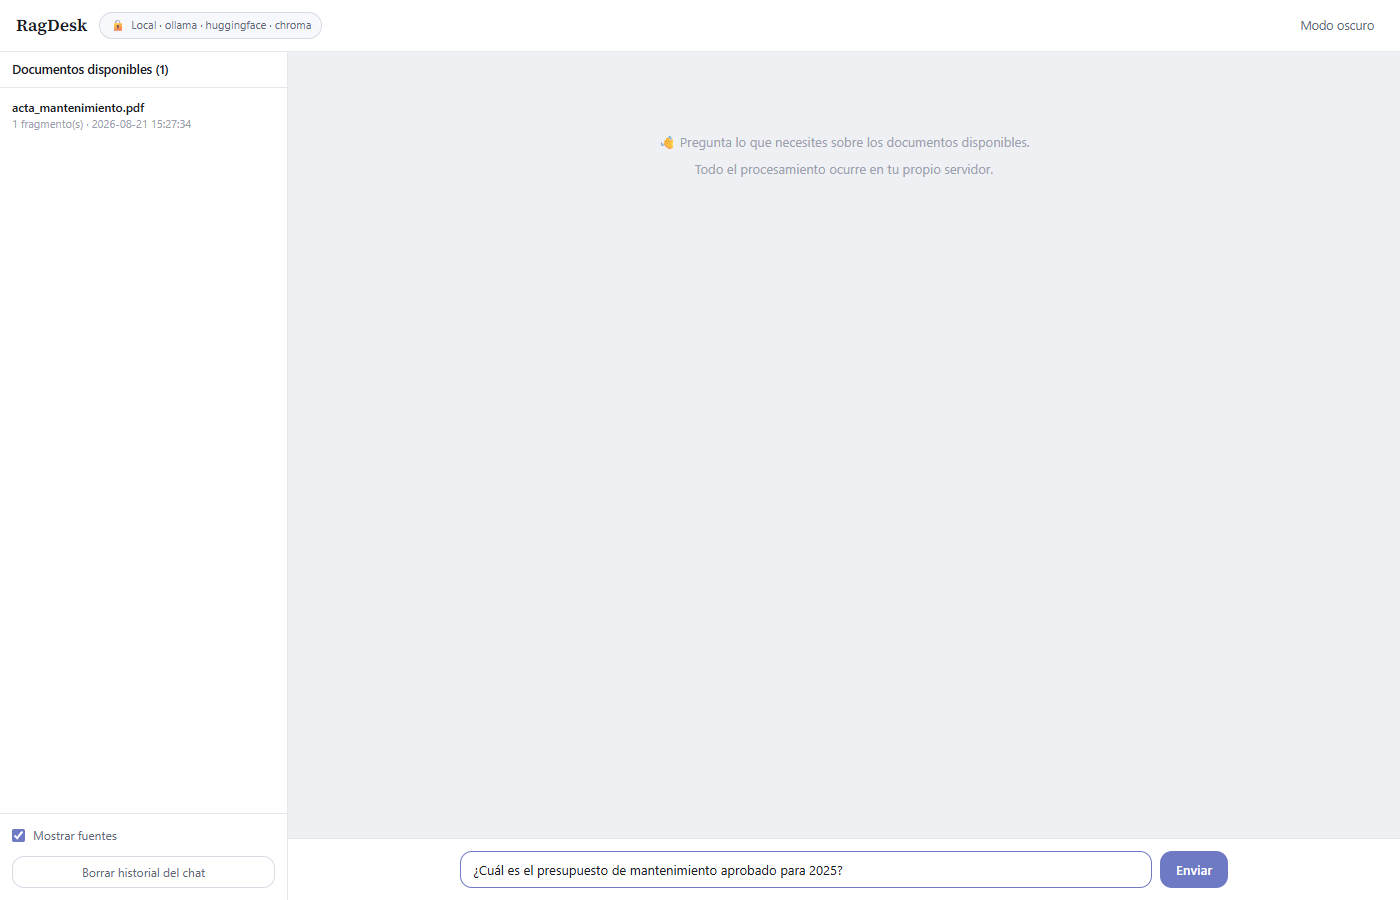
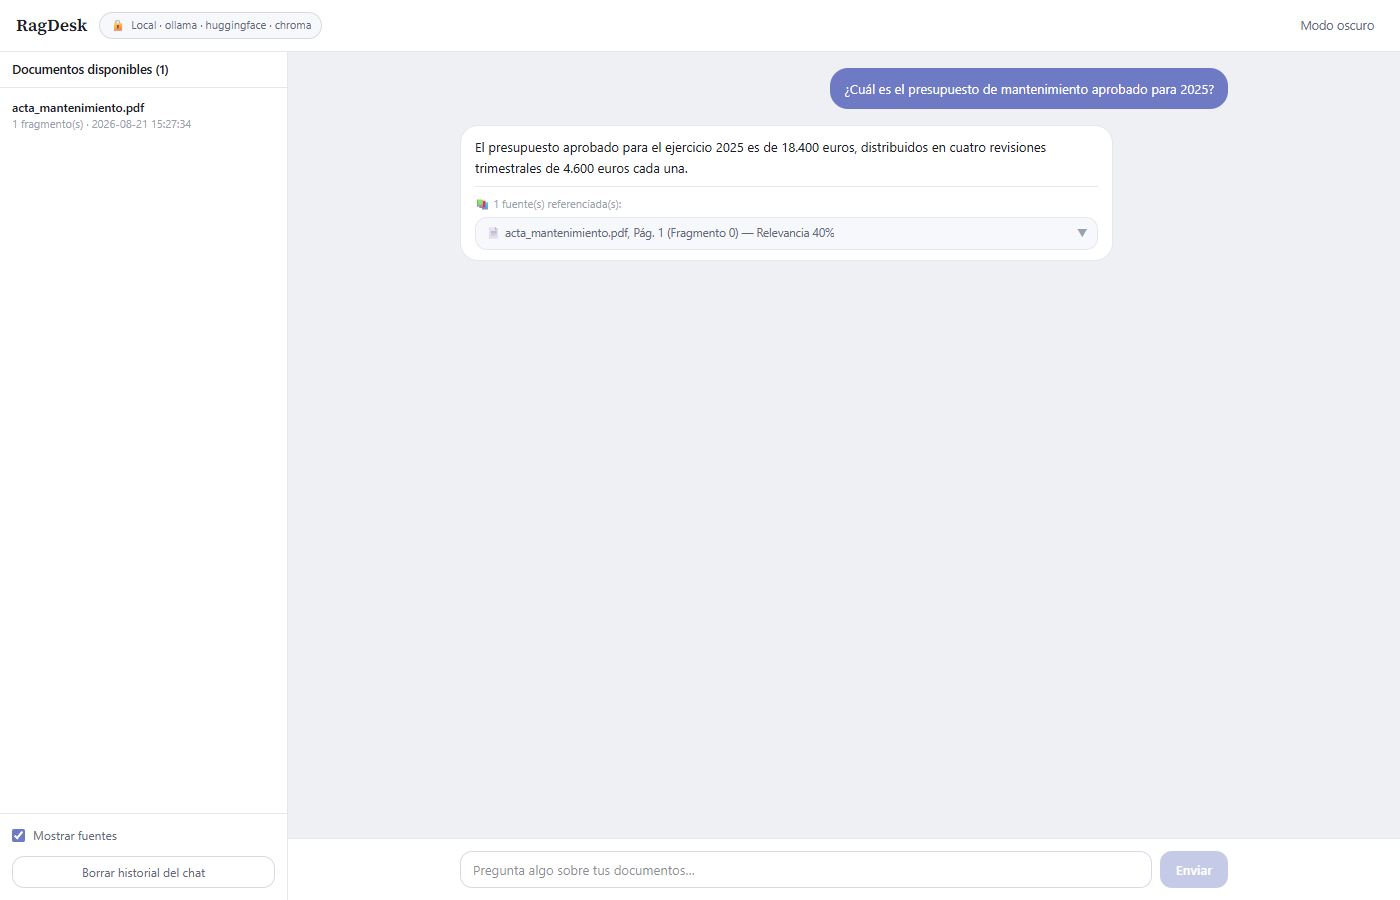
Responde preguntas en lenguaje natural sobre una colección de documentos, citando siempre la página exacta de origen. Funciona enteramente en local cuando así se requiere, sin subir la documentación a ningún servicio externo; admite modelos en la nube como alternativa configurable.
Answers natural-language questions over a document collection, always citing the exact source page. Runs entirely locally when required, with no documents leaving the machine; cloud models are supported as a configurable alternative.
FastAPI · LlamaIndex · Ollama o proveedor en la nube · app de escritorio (Tauri) y despliegue web
FastAPI · LlamaIndex · Ollama or cloud provider · desktop app (Tauri) and web deployment
TalCual (Asistente de estudio para academias de oposiciones)(Study assistant for exam-prep academies)
Piloto con academiasPilot with academies
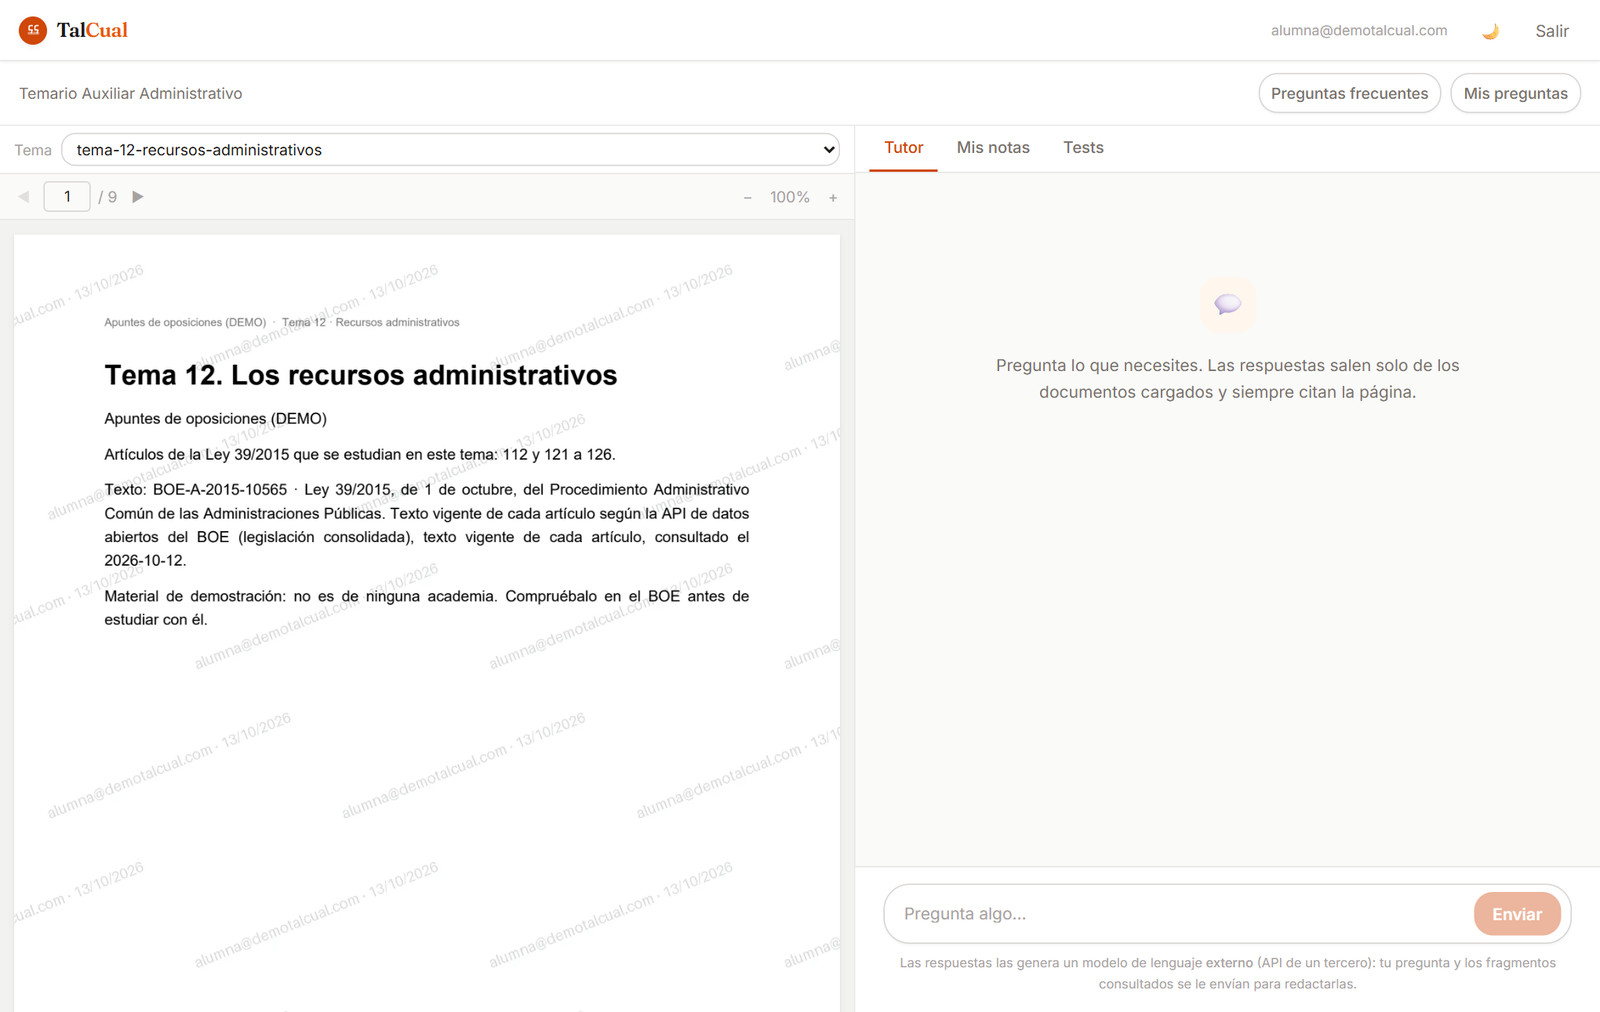
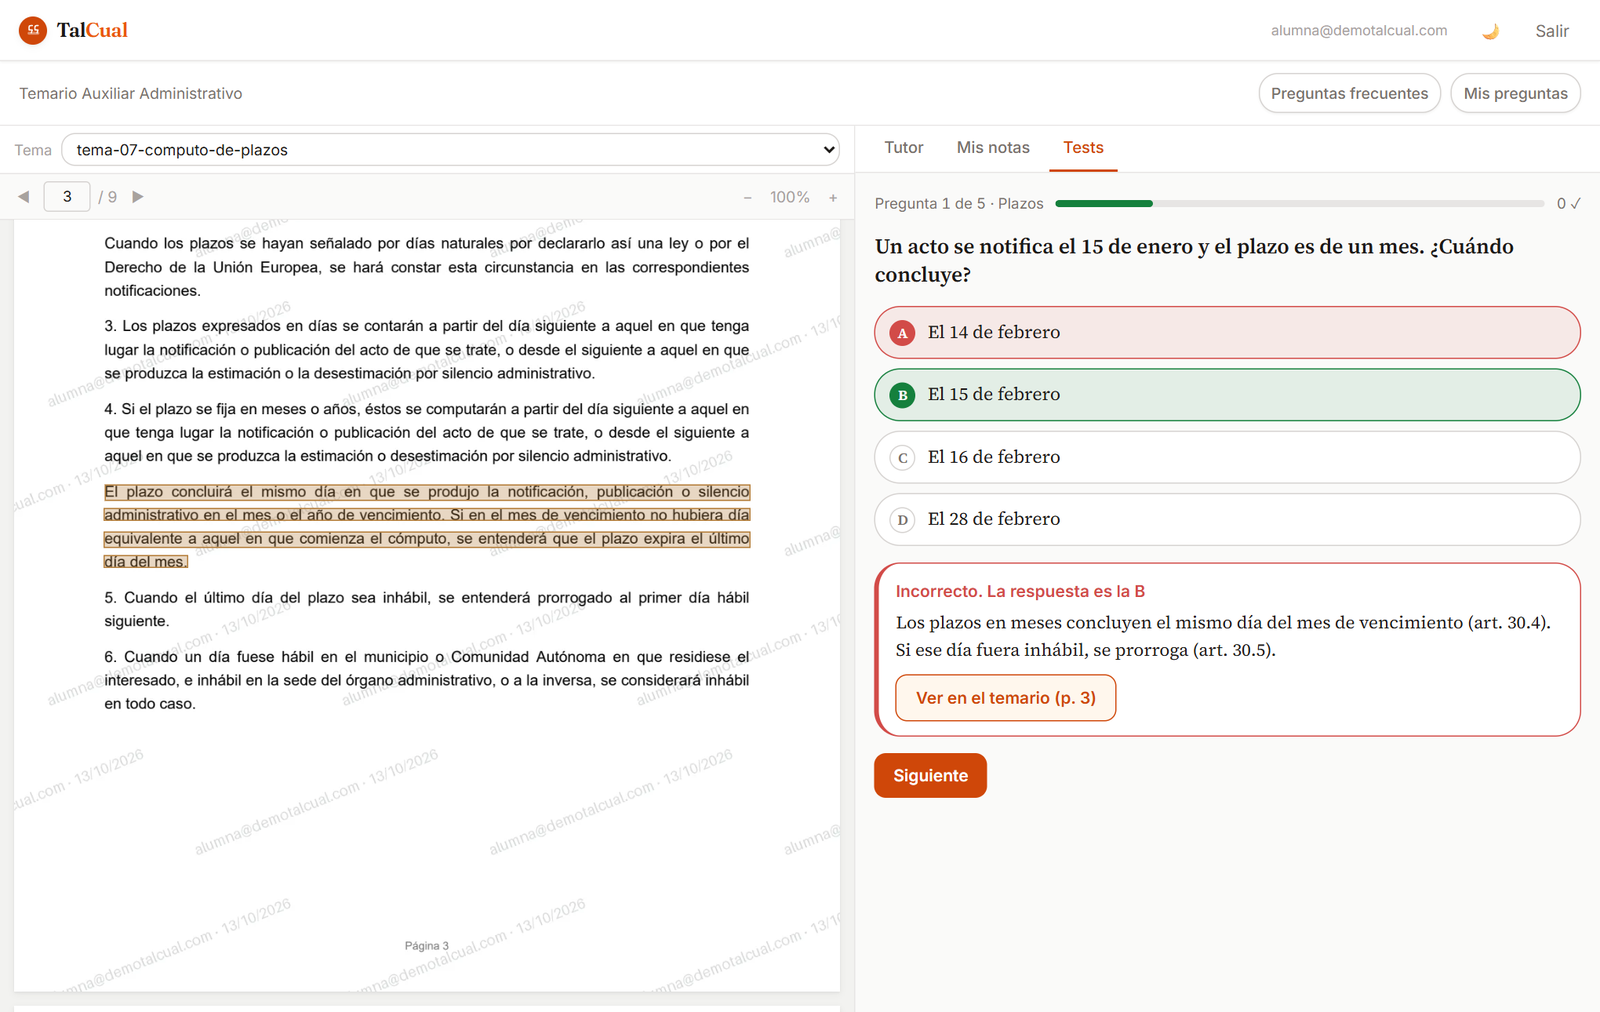
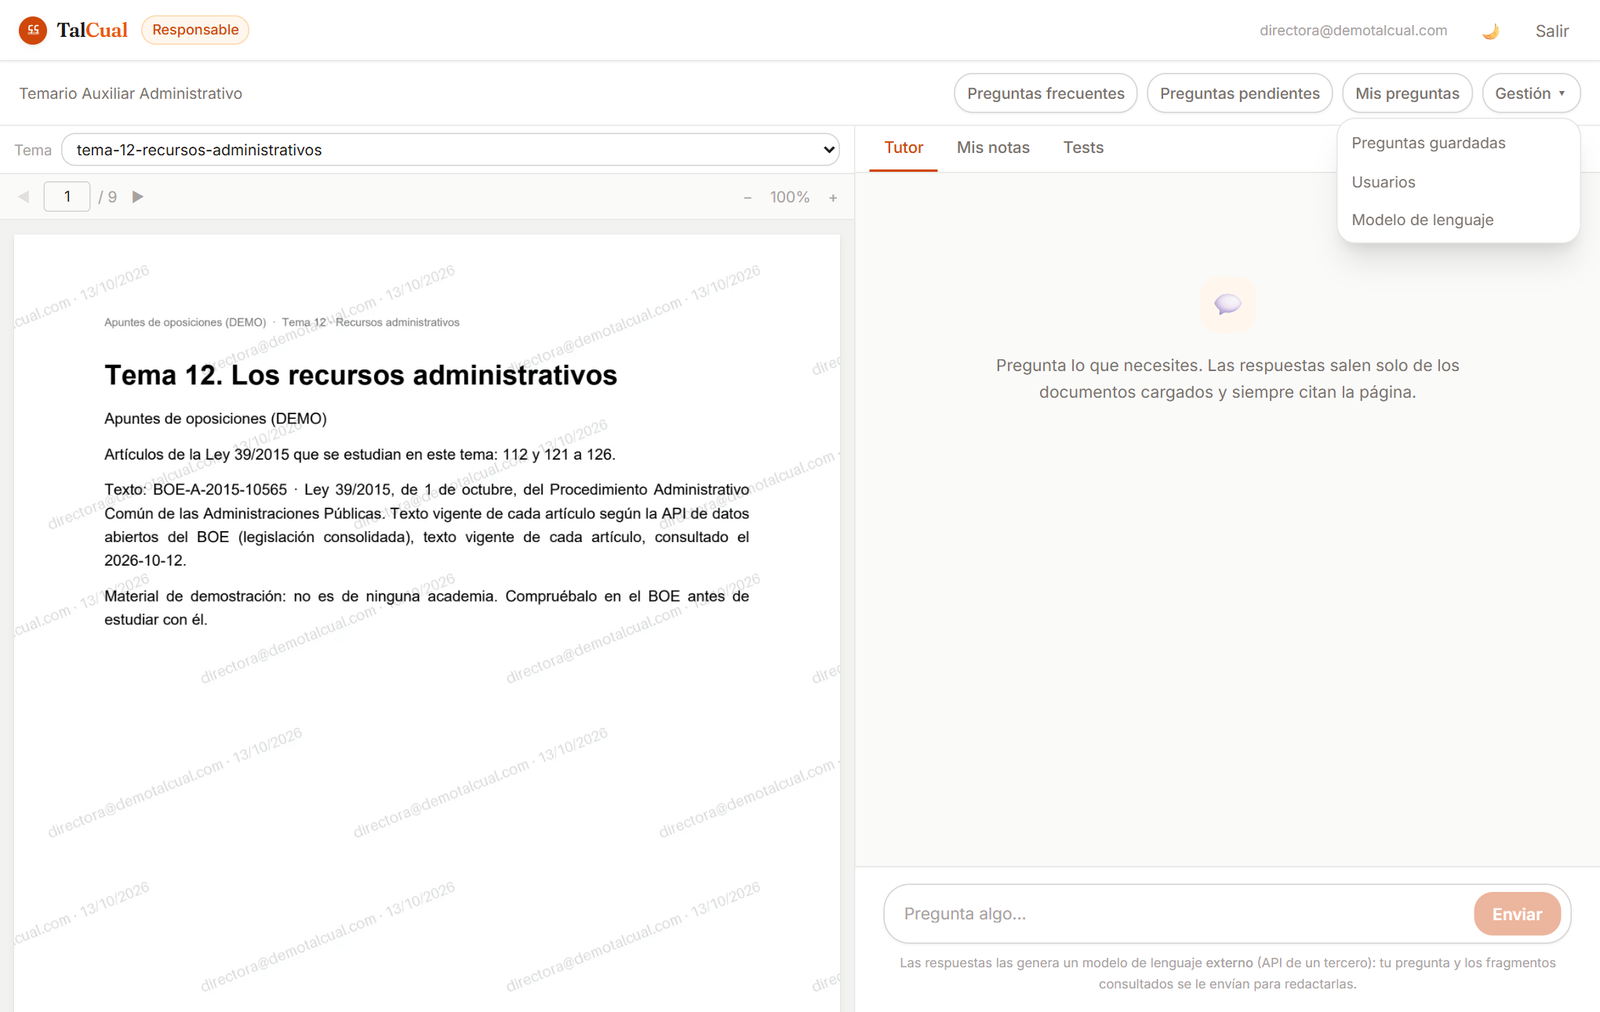
Un asistente para los alumnos de una academia que responde solo con su temario, cita el artículo y la página y abre el documento en el pasaje exacto. Si el alumno duda, pide revisión a un preparador; esa respuesta queda guardada y revisada para los siguientes. Incluye tests por tema enlazados al punto del temario que responde cada pregunta.
An assistant for an academy's students that answers only from its syllabus, cites the article and page, and opens the document at the exact passage. If a student has doubts, they can ask a tutor to review it; that answer is saved and verified for the next students. It includes topic tests linked to the exact point of the syllabus that answers each question.
Cada academia con sus datos separados · visor con marca de agua · roles de alumno, experto y responsable · mismo motor que RagDesk
Each academy's data kept separate · watermarked viewer · student, expert and manager roles · same engine as RagDesk
Capturas de la aplicación con un temario de demostración (texto de la Ley 39/2015, BOE); academia y usuarios ficticios.
Screenshots of the application with a demonstration syllabus (text of Spanish Law 39/2015, BOE); fictitious academy and users.
Se empieza con un piloto corto y gestionado, sobre un tema de tu temario. El asistente puede equivocarse: por eso cita siempre la fuente y existe la revisión por un preparador.
It starts with a short, managed pilot on one topic of your syllabus. The assistant can be wrong, which is why it always cites its source and tutor review exists.
NeuAlz(Lector de PDF y base de conocimiento)(PDF reader & knowledge base)
En desarrolloIn development
Lee, resalta y organiza tus PDF en una biblioteca de citas clasificada y buscable, con salto directo a la página original — todo en local. Tres variantes (académica, legal, empresarial) comparten el mismo código.
Read, highlight and organize your PDFs into a searchable, classified citation library, with a direct link back to the original page — all locally. Three variants (academic, legal, business) share the same codebase.
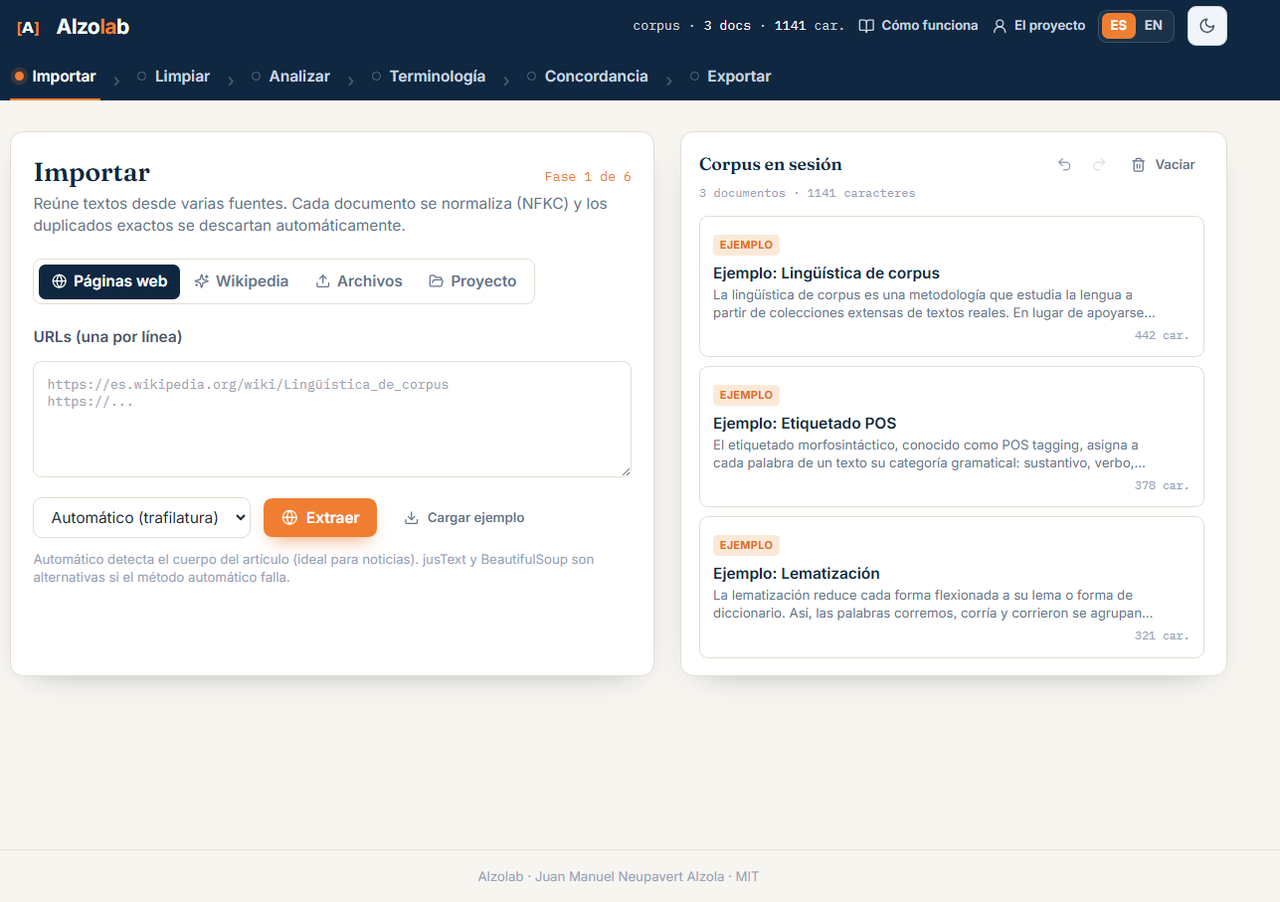
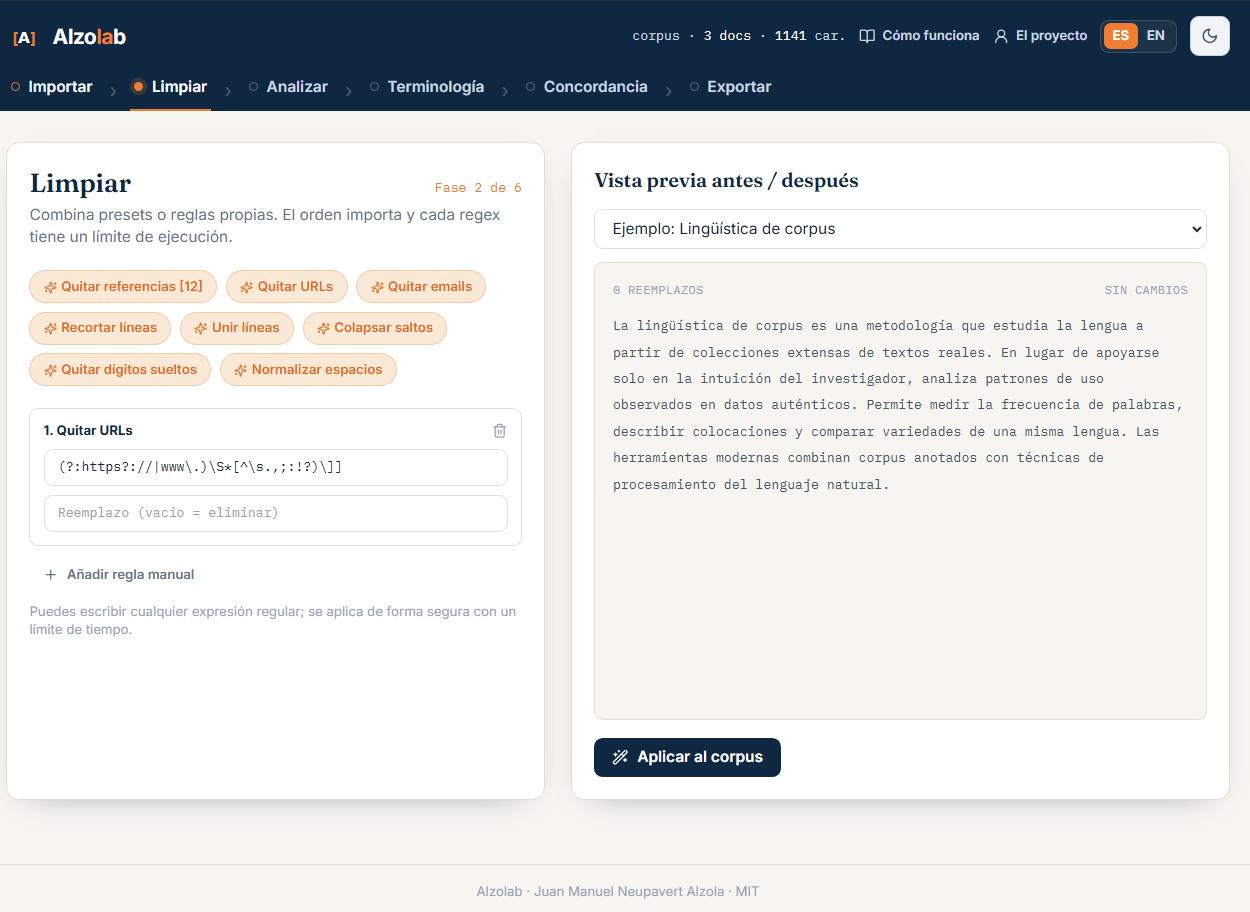
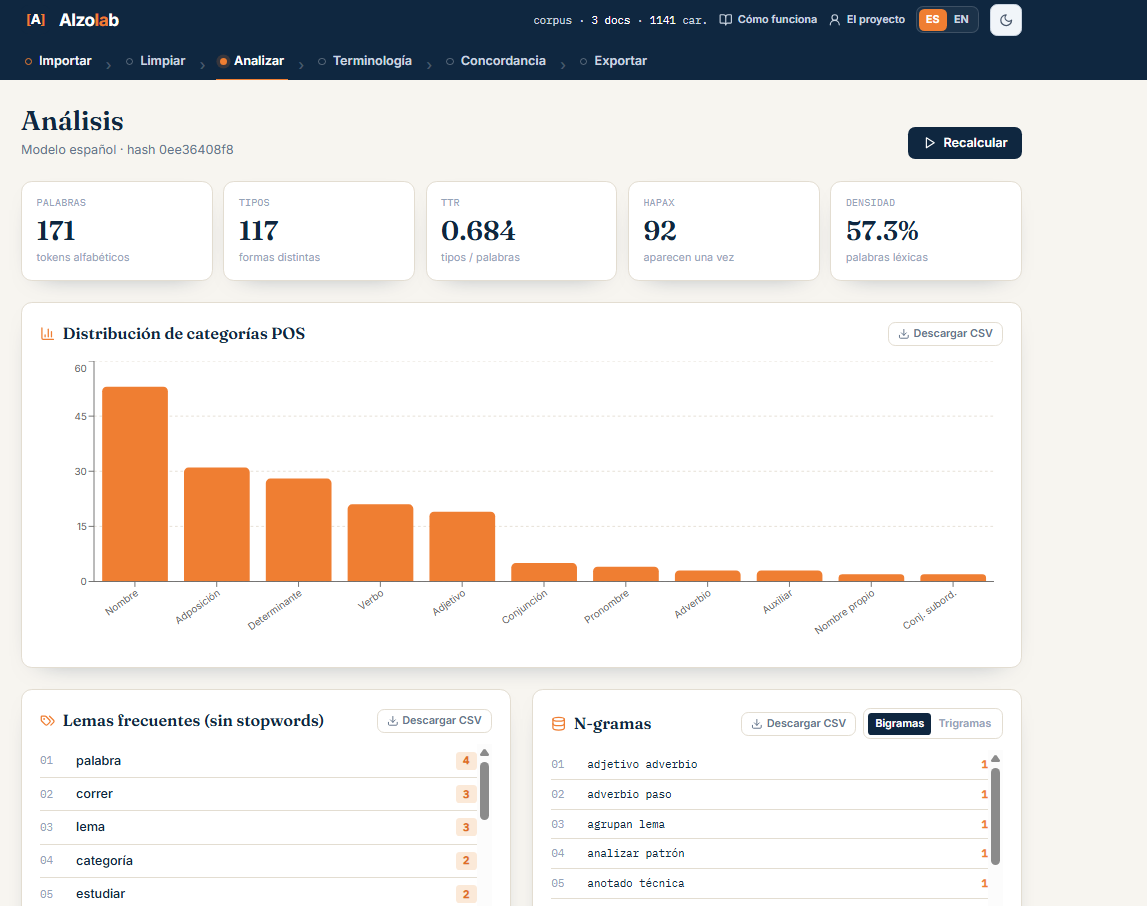
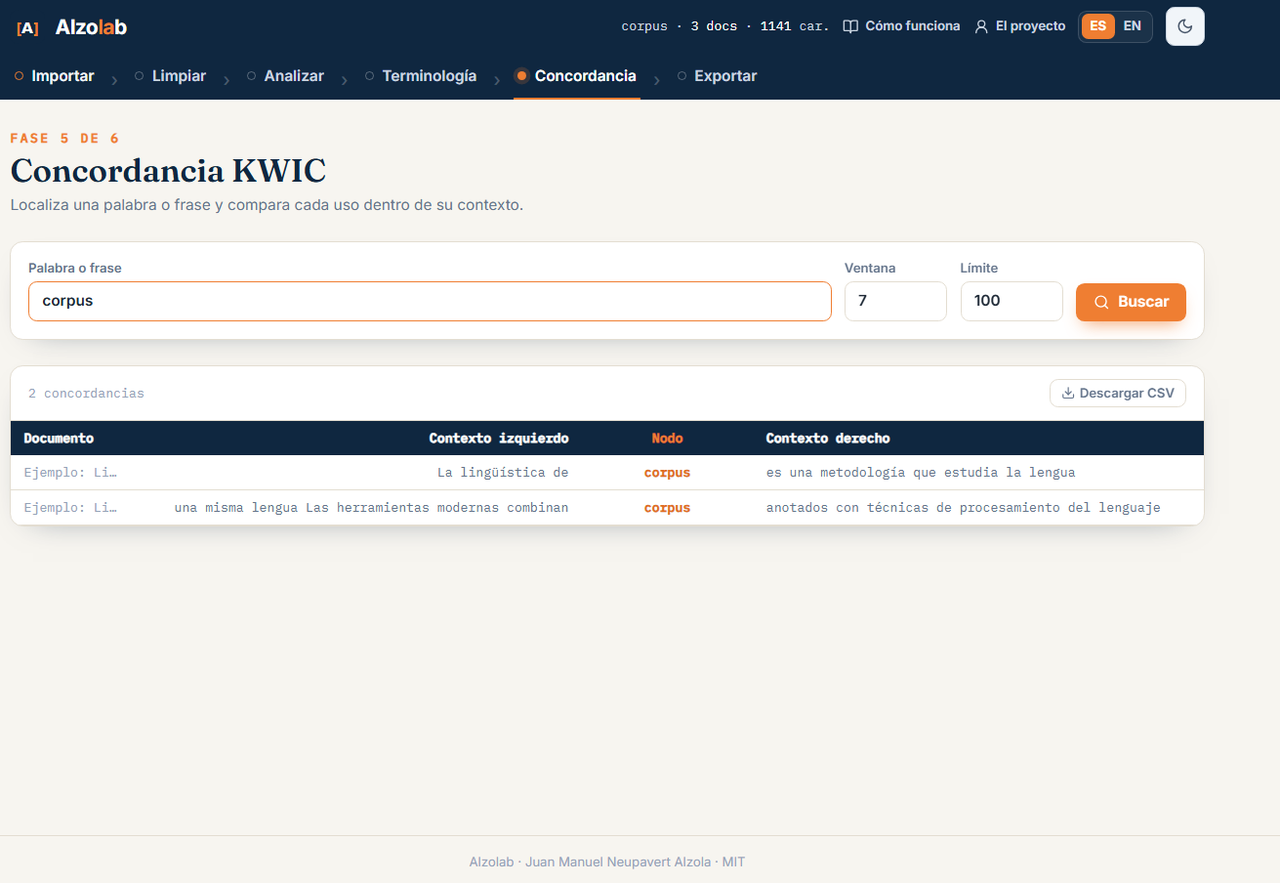
Laboratorio de lingüística de corpus en el navegador, sin escribir código. Flujo completo: importación multifuente (web, Wikipedia, archivos) → limpieza y normalización → análisis morfosintáctico con spaCy → extracción terminológica (C-value) → concordancias KWIC → exportación.
Browser-based corpus-linguistics lab, no coding required. End-to-end flow: multi-source import (web, Wikipedia, files) → cleaning and normalization → morphosyntactic analysis with spaCy → term extraction (C-value) → KWIC concordances → export.
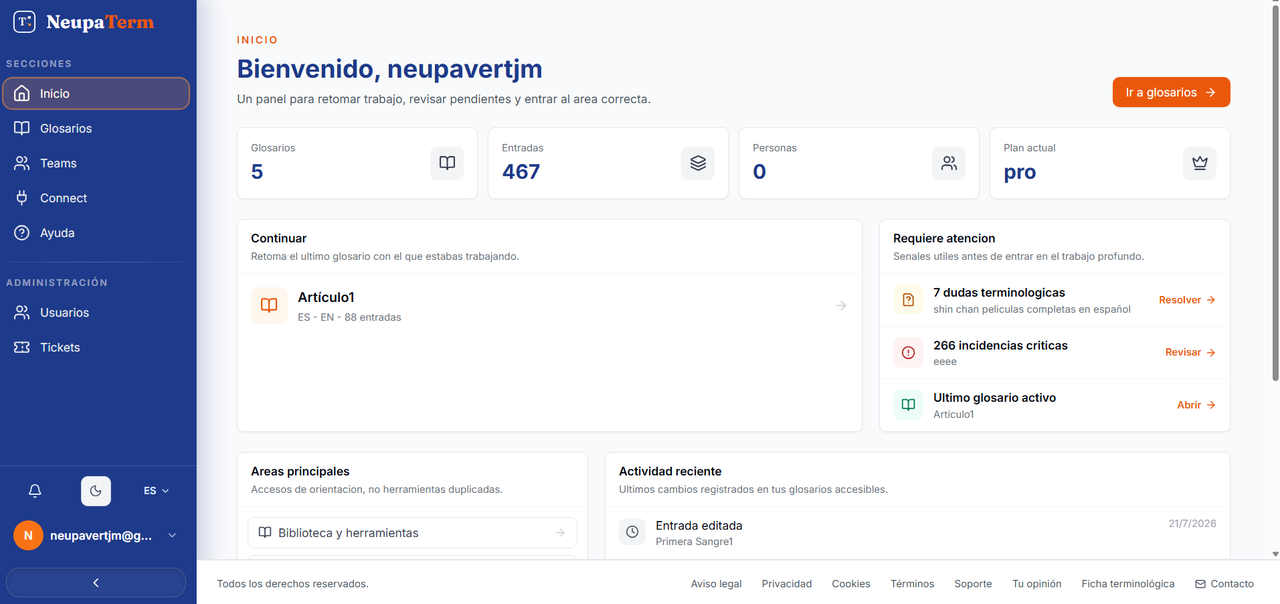
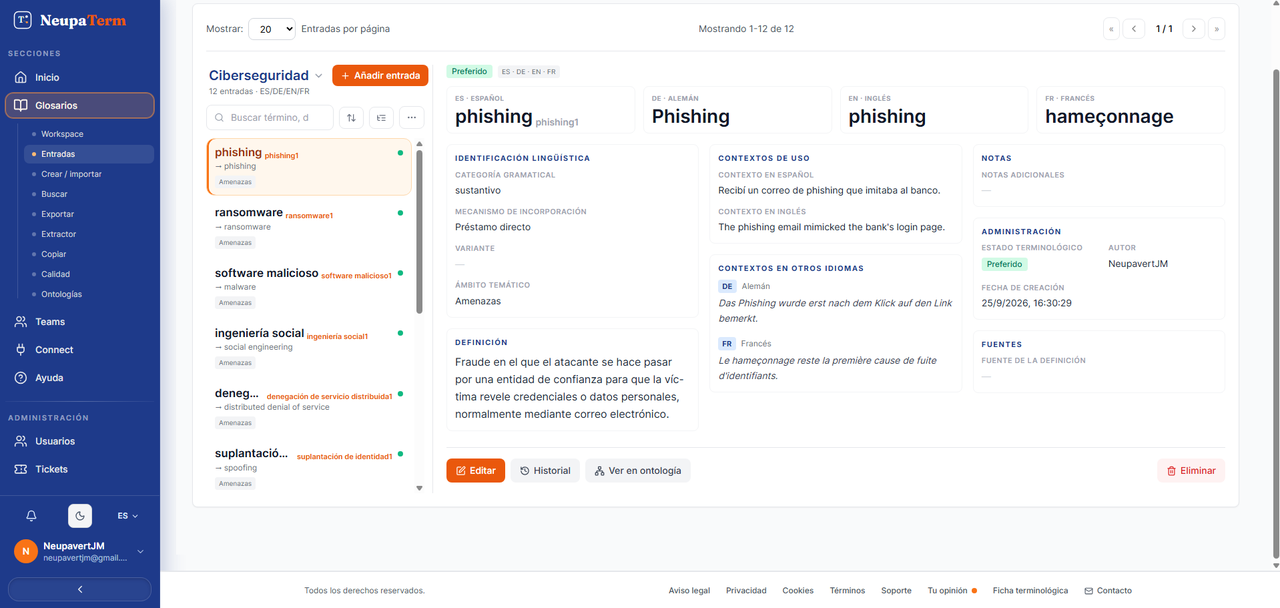
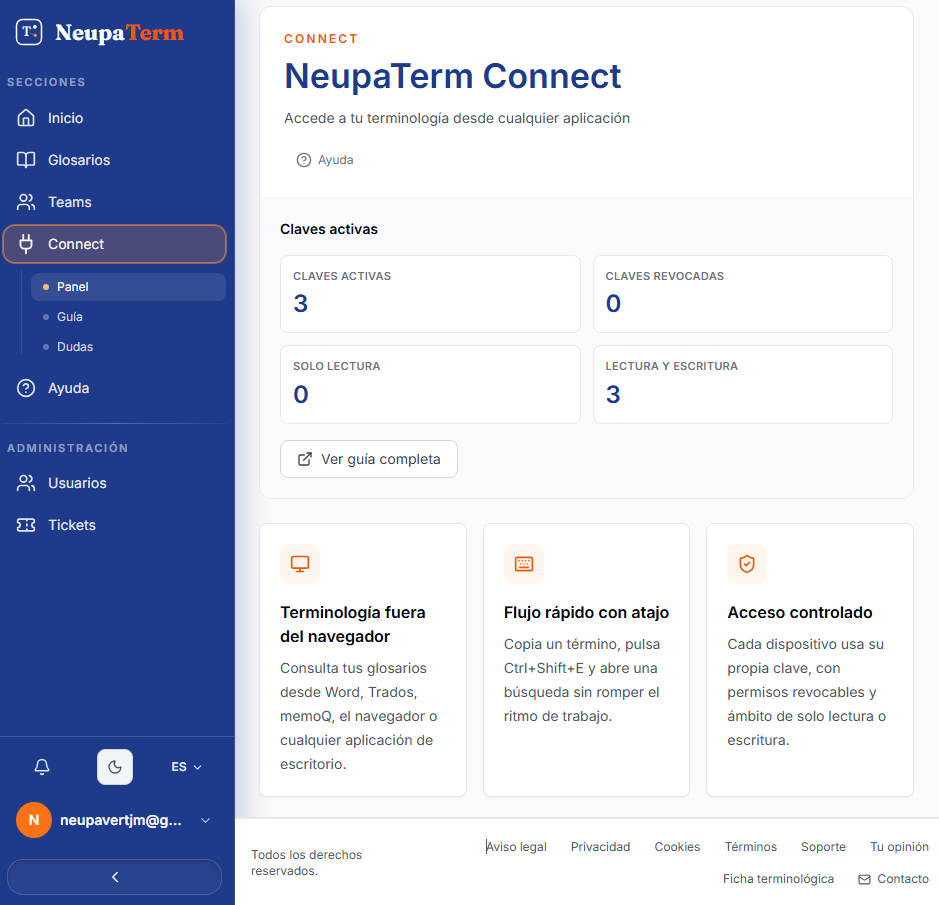
Plataforma SaaS de gestión terminológica multilingüe, independiente del CAT. Glosarios y fichas terminológicas en n lenguas, con todas las equivalencias de un concepto en una misma ficha (ES · EN · PT · DE · IT · FR): categoría gramatical, contextos de uso y equivalencias por idioma. Extracción de candidatos con NLP y consulta de la terminología desde Word, Trados, memoQ o cualquier otra aplicación (NeupaTerm Connect).
CAT-independent, multilingual terminology-management SaaS. Glossaries and terminological records in n languages, with every equivalent of a concept on a single record (ES · EN · PT · DE · IT · FR): grammatical category, usage contexts and cross-language equivalences. NLP-based candidate extraction and terminology lookup from Word, Trados, memoQ or any other application (NeupaTerm Connect).
Plataforma para la documentación de lenguas minoritarias y en peligro. Interoperabilidad FLEx/ELAN/CLDF, glosa interlineal Leipzig, consentimiento informado (CARE/FAIR) y editor offline.
Platform for documenting minority and endangered languages. FLEx/ELAN/CLDF interoperability, Leipzig interlinear glossing, informed consent (CARE/FAIR) and offline editor.
Escenarios ilustrativos de aplicación, no trabajos realizados para un cliente real — cada uno indica explícitamente que es un demostrador.
Illustrative application scenarios, not work done for a real client — each one explicitly flags itself as a demonstrator.
[academia de oposiciones]Dudas del temario, con la página exactaSyllabus questions, with the exact page
Una academia cuyos preparadores contestan una y otra vez las mismas dudas podría ofrecer a sus alumnos un asistente que responde solo con su temario, cita el artículo y la página, y deja las respuestas de los preparadores guardadas para el siguiente alumno. El piloto empezaría con un solo tema.
An academy whose tutors keep answering the same questions could give its students an assistant that answers only from its syllabus, cites the article and page, and keeps the tutors' answers saved for the next student. The pilot would start with a single topic.
demostrador — sin cliente realdemonstrator — no real client
[despacho profesional]Consulta interna sobre expedientesInternal query over case files
Un despacho con miles de expedientes en papel y PDF escaneado necesita buscar cláusulas y precedentes sin releer carpeta por carpeta. El Digitalizador OCR y RagDesk cubrirían ese flujo, citando siempre la página exacta del expediente.
A firm with thousands of paper and scanned-PDF case files needs to search clauses and precedents without re-reading folder by folder. The OCR digitizer and RagDesk would cover that flow, always citing the exact page of the file.
demostrador — sin cliente realdemonstrator — no real client
[archivo histórico]Digitalización de fondo documental antiguoDigitizing an old archival collection
Un archivo municipal o una biblioteca con fondos manuscritos o mecanografiados antiguos podría digitalizarse y quedar disponible para consulta en lenguaje natural, marcando explícitamente los fragmentos que la máquina no ha podido leer con confianza en vez de inventarlos.
A municipal archive or library with old manuscript or typewritten collections could be digitized and made available for natural-language search, explicitly flagging fragments the machine couldn't read with confidence instead of guessing them.
demostrador — sin cliente realdemonstrator — no real client
[documentación técnica]Asistente sobre manuales y procedimientosAssistant over manuals and procedures
Una empresa con manuales de producto, procedimientos internos y normativa dispersa en cientos de documentos podría centralizarlos en un asistente de consulta privado, para que cualquier empleado pregunte en lenguaje natural en vez de bucear en carpetas compartidas. Puedes ver el patrón funcionando en la demo pública de RagDesk.
A company with product manuals, internal procedures and regulations scattered across hundreds of documents could centralize them into a private query assistant, so any employee can ask in natural language instead of digging through shared folders. You can see the pattern in action in the public RagDesk demo.
demostrador — sin cliente realdemonstrator — no real client
[traducción / localización]Coherencia terminológica entre idiomasCross-language terminology consistency
Un equipo de traducción o localización que necesita coherencia terminológica entre idiomas se beneficiaría de una base terminológica centralizada (NeupaTerm) con control de calidad terminológica automatizado sobre sus entregas.
A translation or localization team that needs terminology consistency across languages would benefit from a centralized termbase (NeupaTerm) with automated terminology QA over their deliverables.
demostrador — sin cliente realdemonstrator — no real client
[terminología especializada]Extracción de glosario desde un corpus propioExtracting a glossary from an in-house corpus
Un equipo de investigación o una editorial especializada que trabaja con un corpus de textos técnicos podría extraer su propia terminología con AlzoLab y construir un glosario reutilizable, en vez de identificar términos a mano uno por uno.
A research team or specialized publisher working with a corpus of technical texts could extract its own terminology with AlzoLab and build a reusable glossary, instead of identifying terms by hand one at a time.
demostrador — sin cliente realdemonstrator — no real client
[archivos documentales grandes]Extracción de datos desde facturas y contratosData extraction from invoices and contracts
Una empresa con grandes volúmenes de facturas, contratos o formularios en PDF/Word podría automatizar la extracción de sus datos hacia una hoja de cálculo o base de datos, en lugar de copiarlos a mano uno a uno.
A company with large volumes of invoices, contracts or forms in PDF/Word could automate extracting their data into a spreadsheet or database, instead of copying them by hand one at a time.
demostrador — sin cliente realdemonstrator — no real client
El tamaño del proyecto varía mucho: desde una digitalización puntual de una tarde hasta una integración de varias semanas. El precio siempre se cierra por escrito después de conocer el caso, nunca antes.
Project size varies a lot: from a one-afternoon digitization job to a multi-week integration. The price is always closed in writing after seeing the actual case, never before.
1. Reunión inicial (15-20 min) — sin compromiso, hablamos de tu problema documental concreto.
1. Initial call (15-20 min) — no strings attached, we talk through your actual document problem.
2. Propuesta por escrito — qué se entrega, precio cerrado sobre un alcance definido, y plazo, antes de empezar nada. Si el alcance cambia por el camino, se cotiza aparte — nunca se absorbe en el precio ya cerrado.
2. Written proposal — what gets delivered, fixed price for a defined scope, and timeline, before anything starts. If the scope changes along the way, that gets quoted separately — never absorbed into the price already agreed.
3. Implementación sobre tus propios documentos — en local si así lo prefieres, sin subir nada a terceros.
3. Implementation on your own documents — locally if you prefer, nothing uploaded to third parties.
4. Entrega y formación breve — 15-30 minutos para que tu equipo lo use sin depender de mí.
4. Delivery and a short walkthrough — 15-30 minutes so your team can use it without depending on me.
5. Mantenimiento opcional — si lo necesitas, sigo disponible mes a mes; si no, el proyecto queda cerrado.
5. Optional ongoing maintenance — available month to month if you need it; otherwise the project is simply done.
Tus documentos, seguros
Your documents, safe
Trabajar con la documentación de una empresa es una responsabilidad. Así la trato:
Working with a company's documents is a responsibility. This is how I handle it:
Canal seguro. Los documentos llegan por una vía acordada contigo o por tu propio sistema, nunca en correos sueltos.
Secure channel. Documents arrive through a channel agreed with you, or through your own system — never as loose email attachments.
Aislados y cifrados. Se trabajan en un equipo con el disco cifrado, en una carpeta exclusiva para tu empresa, sin mezclarse con los de ningún otro cliente.
Isolated and encrypted. They are processed on a machine with an encrypted disk, in a folder exclusive to your company, never mixed with any other client's.
Procesamiento en local. El OCR, la clasificación y la extracción se hacen en mi equipo. Tus documentos no se envían a servicios de inteligencia artificial en la nube salvo que lo autorices por escrito para una tarea concreta.
Local processing. OCR, classification and extraction run on my own machine. Your documents are not sent to cloud AI services unless you authorize it in writing for a specific task.
Borrado con certificado. Cumplido el plazo de conservación acordado, tus datos se eliminan de forma segura y recibes un certificado de qué se ha borrado y cuándo.
Deletion with a certificate. Once the agreed retention period ends, your data is securely deleted and you receive a certificate of what was deleted and when.
Marco RGPD. Actúo como encargado del tratamiento (art. 28 RGPD), con contrato de encargo y registro de actividades. Más detalle.
GDPR framework. I act as data processor (Art. 28 GDPR), with a processing agreement and a record of processing activities. More detail.
Creador y desarrollador · TalCual (asistente de estudio para academias de oposiciones)
Creator & Developer · TalCual (study assistant for exam-prep academies)
2026 · actualidad
2026 – present
Producto principal: un asistente que responde solo con el temario de la academia, cita el artículo y la página y abre el documento en el pasaje exacto, con revisión de las dudas por un preparador y respuestas guardadas y verificadas.
Main product: an assistant that answers only from the academy's syllabus, cites the article and page, and opens the document at the exact passage, with tutor review of doubtful answers and saved, verified responses.
Diseño y desarrollo completo (FastAPI, LlamaIndex, React): recuperación con citas, visor protegido con marca de agua, tests por tema enlazados al temario, roles de alumno, experto y responsable, y datos separados por academia.
Full design and development (FastAPI, LlamaIndex, React): retrieval with citations, watermarked protected viewer, topic tests linked to the syllabus, student, expert and manager roles, and per-academy data separation.
Prioridad en la fiabilidad: corrección de premisas falsas en las preguntas, rechazo de preguntas ajenas al temario y evaluación medible de la búsqueda antes y después de cada cambio.
Reliability first: correcting false premises in questions, refusing questions outside the syllabus, and measurable retrieval evaluation before and after each change.
Cumplimiento RGPD desde el diseño: avisos legales y de privacidad, descarga y borrado de datos del usuario y borrador de contrato de encargo de tratamiento para cada academia.
GDPR by design: legal and privacy notices, user data export and deletion, and a draft data-processing agreement for each academy.
Desarrollador NLP y lingüista computacional · NeupaTerm
Diseño y desarrollo de una plataforma SaaS de gestión terminológica con pipeline NLP completo (React/Vite + FastAPI + PostgreSQL + spaCy).
Design and development of a terminology-management SaaS platform with a full NLP pipeline (React/Vite + FastAPI + PostgreSQL + spaCy).
Integración de LLMs mediante prompt engineering (Claude, GPT) para clasificación de términos, evaluación lingüística y enriquecimiento semántico de bases de datos.
Integration of LLMs through prompt engineering (Claude, GPT) for term classification, linguistic evaluation, and semantic enrichment of databases.
Procesamiento con spaCy: reconocimiento de entidades (NER), desambiguación de términos polisémicos y extracción de relaciones sobre corpus multilingües especializados (EN–ES).
spaCy processing: named-entity recognition (NER), disambiguation of polysemous terms, and relation extraction over specialized multilingual corpora (EN–ES).
Modelo de datos terminológico como grafo conceptual (relaciones jerárquicas, partitivas y asociativas), con exportación a CSV, JSON y TMX.
Terminology data model designed as a conceptual graph (hierarchical, part-whole, and associative relations), with export to CSV, JSON, and TMX.
Investigador NLP en prácticas · Instituto de Lingüística Aplicada (ILA), Universidad de Cádiz
NLP Researcher — Practicum · Institute of Applied Linguistics (ILA), University of Cádiz
2025 · 150 h
2025 · 150 h
Desarrollo de una aplicación Streamlit para limpieza y normalización automatizada de grandes conjuntos de datos (.txt/JSON), con control de calidad lingüística basado en reglas y NLP.
Development of a Streamlit application for automated cleaning and normalization of large datasets (.txt/JSON), with rule- and NLP-based linguistic quality control.
Colaboración en un sistema RAG para investigación lingüística aplicada (ingesta de documentos y recuperación mediante LLM).
Collaboration on a RAG system for applied linguistic research (document ingestion and LLM-based retrieval).
Formación
Education
Máster en Ciencias del Lenguaje
Master's in Language Sciences
UCA · 2025 · Media: 9,2 · TFM: M. de Honor
University of Cádiz · 2025 · GPA: 9.2/10 · Thesis: highest distinction
Doble Grado: Lingüística y Lenguas Aplicadas + Estudios Ingleses
Double Bachelor's: Linguistics & Applied Languages + English Studies
Universidad de Cádiz · 2022
University of Cádiz · 2022
Publicaciones
Publications & talks
Comunicación — AESLA 2026, Granada
Conference talk — AESLA 2026, Granada
Comunicación — Congreso Tránsitos 2026, Cádiz
Conference talk — Tránsitos Congress 2026, Cádiz
Póster — Congreso AETER 2025
Poster — AETER Conference 2025
Competencias
Skills
Terminología y terminografía · Lenguaje especializado · Lingüística de
corpus · NLP y spaCy (NER, desambiguación, extracción de relaciones) ·
LLMs y prompt engineering (Claude, GPT) · RAG y recuperación vectorial
(Ollama, LlamaIndex) · Representación del conocimiento (SKOS, RDF, OWL;
SPARQL) · Estándares de interoperabilidad (TBX, XLIFF, TMX) ·
FLEx/LIFT · ELAN/EAF · CLDF · Sketch Engine · UAM CorpusTool · AntConc ·
Lingmotif · PostgreSQL / SQL · MateCat · Subtitle Edit · Python (FastAPI,
Streamlit) · Inglés · Francés (básico) · Español nativo